
最初に、TypeSafe AIのJevが文章を生成せず、型付きの選択、評点、真偽値と確率を返す設計を確認してください。9月18日に公開されたVercel AI Gatewayの採用データと独立評価を使い、速度と費用だけでなく精度、校正、適用範囲を検証します。続いて、AlloyDBとCloud SQLのBM25検索、Googleの脆弱性スキャン、AgentCore Runtime、HyperPodのGPU対応ルーティングを整理します。OpenAIへの侵入研究では、脆弱性の連鎖とClaude Opus 5による実用エクスプロイト作成を追います。
今日の焦点は、生成モデルへ任せていた小さな判断を、確率付きの専用モデルと通常のコードへどう分けるかです。Jevの適用条件を起点に、BM25とベクトル検索の役割分担、人間による修正案のレビュー、測定条件付きの起動性能、GPU信号による転送を確認します。加えて、OpenAIへの侵入経路とアカウント到達、Claude Opus 5による実用エクスプロイト作成、修正状況から防御上の判断点を捉えます。(出典1 / 出典2 / 出典3 / 出典4 / 出典5 / 出典6 / 出典7 / 出典8)
Jev、型付き確率判断に特化したSystem Oneモデル
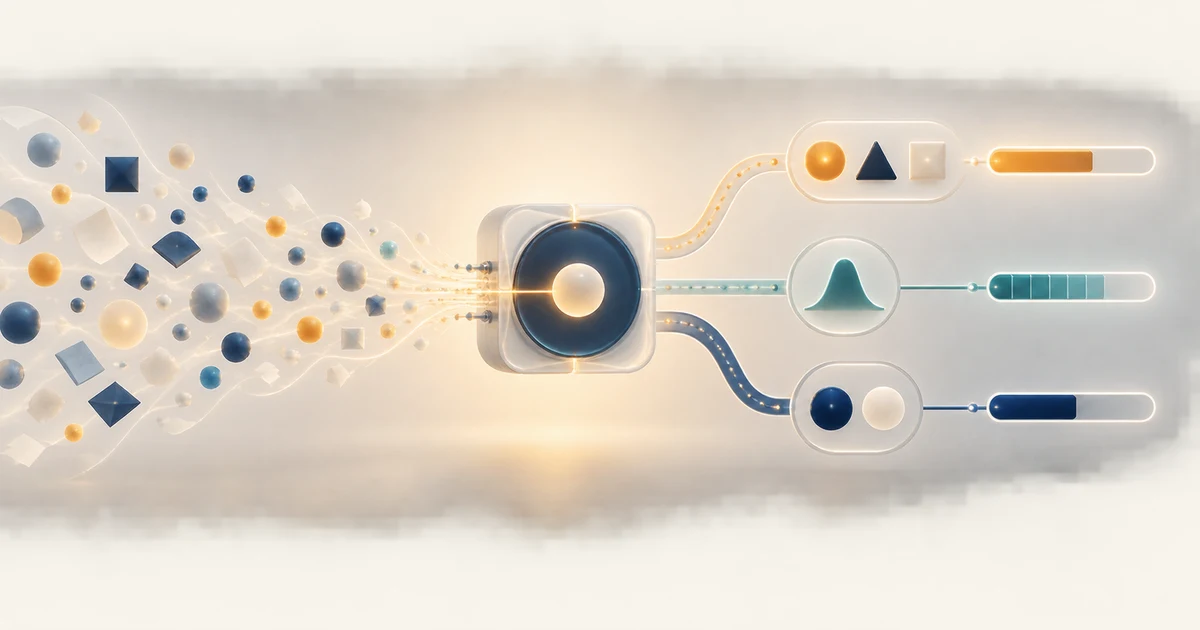
TypeSafe AIが9月15日に公開したJevは、文章を生成する汎用LLMではなく、ソフトウェア内の限定された判断に特化した最初のSystem Oneモデルである。アプリケーションが状態と質問を送り、Jevは事前に定義した型の値、選択肢ごとの確率、信頼度を返す。出力を文章から再解析する必要がなく、コードは確率に基づいて分岐、並べ替え、転送を行える。(出典1 / 出典2)
公開APIの質問型は3種類である。Choiceは定義済み候補から一つを選び、Scoreはrubric上の段階を返し、Noulは命題の真偽を0から1の値で表す。1回の呼び出しで複数の質問型を混在でき、同じ状態に対する各質問を独立して並列評価する。質問同士は依存できないため、複数要因を要する判断は個別質問へ分解し、重み付けや停止条件をコード側で合成する設計になる。(出典2)
比較表: Jevと汎用LLMの役割差
Jevは生成能力を削り、定義済みの判断をソフトウェアへ直接返す。汎用LLMを置き換えるものではなく、生成前後の転送、判定、検証を高速に繰り返す層として使う設計である。(出典1 / 出典2)
| 観点 | Jev | 汎用LLM |
|---|---|---|
| 出力 | Choice、Score、Noulと確率分布を定義済みの型で返す。(出典2) | 文章やコードをtoken単位で生成し、ソフトウェア利用時は構造の検証が必要になる。(出典1) |
| 適する処理 | 転送、分類、優先度付け、継続や停止の判定、生成結果の検証。(出典3) | 説明、要約、コード生成、複数段階の推論など、自由形式の出力を要する処理。(出典1) |
| 制御方法 | 原子的な質問を並列評価し、確率の閾値と業務規則をコードで合成する。(出典2) | promptと生成結果の検証を組み合わせ、必要に応じて再試行する。(出典1) |
TypeSafeが公表する価格は入力100万token当たり0.042ドルで、出力は無料である。end-to-endの応答時間は70msから500msとしている。同社のworkflow評価では最大193.6倍高速、444.6倍低費用という結果を示す一方、その値は実運用で期待する改善幅の上限寄りで、評価workflowをmodel capability teamが作成したためbiasの可能性もあると明記している。(出典1)
9月18日公開の独立評価Jevalsは、3種類の質問ごとに300問を5回実行した。NoulではJevとGemini 3.8 Flashの差を示す95%区間が0を含み、統計的な優劣を確認できなかった一方、Jevの費用は1,000判断当たり0.03ドル、P95遅延は0.65秒で、比較対象の0.80ドル、5.5秒を下回った。ChoiceではJevの正答率79.7%に対してGemini 3.8 Flashが有意に上回り、Scoreではどのmodelもlabelの事前分布による推測を明確に上回らなかった。(出典4)
Vercelによると、JevはAI Gatewayでの提供開始から24時間以内に有料teamの約13%で使われ、同gatewayの過去のmodel公開と比べて最速の初動採用になった。GPT-5.6 familyの2倍超、Fable 5.1の6倍超に当たるが、同一gateway内の最初の24時間だけを比較した値であり、継続利用率や業務上の品質を示すものではない。(出典3)
EastBraverの見立て: Jevの価値はLLMの代替ではなく、agentが次のtoolを選ぶ、workflowを続行または停止する、低信頼の判断を人間へ渡すといった高頻度の分岐を専用層へ分離できる点にある。導入時は自社の誤判定costを定義し、confidence閾値ごとのcoverageとaccuracyを実測してから自動化範囲を広げるべきだ。
- 出典: TypeSafe AI(公式情報、2026-09-15) / TypeSafe AI Documentation(公式情報、取得日2026-09-19) / Vercel(公式利用統計、2026-09-18) / Jevals(独立評価、2026-09-18)
関連する技術ガイド: AI Agent
AlloyDBとCloud SQL、ネイティブBM25インデックスをプレビュー
Google Cloudは、AlloyDBとCloud SQLでネイティブBM25インデックスをプレビュー提供した。対象はPostgreSQL 17以降で、Tiger Dataが開発したオープンソースのpg_textsearch拡張機能を利用する。(出典1)
BM25全文検索は、pgtextsearch拡張機能を有効にし、対象のテキスト列へUSING bm25でインデックスを作成して、<@>演算子で実行する。掲載例のtextconfigは英語向けに設定されている。(出典1)
Google Cloudは、ベクトル検索を概念的な意味の把握、従来の全文検索を厳密な識別子やキーワードの照合に使い、両者を組み合わせる方式をハイブリッド検索と説明している。ベクトル検索だけでは扱いにくい厳密な照合を、BM25キーワード検索で補う位置付けだ。(出典1)
ハイブリッド検索の統合方法は製品ごとに異なる。AlloyDBは、同じテーブル上のベクトル索引とキーワード索引の結果を標準提供のUDFがReciprocal Rank Fusionで統合する。Cloud SQLの掲載例では、同じテーブルにHNSWベクトル索引とBM25キーワード索引を置き、Common Table Expressionsで両方の順位とRRFスコアを合成する。(出典1)
比較表: ハイブリッド検索の構成差
両製品とも同一テーブル上のベクトル索引とキーワード索引を統合するが、AlloyDBはReciprocal Rank Fusionを使う標準UDF、Cloud SQLはCommon Table ExpressionsによるSQL例を示している。(出典1)
| 観点 | AlloyDB | Cloud SQL |
|---|---|---|
| 索引の配置 | 同じテーブルにベクトル索引とキーワード索引を作成し、Reciprocal Rank Fusionで統合する。(出典1) | 同じテーブルにHNSWベクトル索引とBM25キーワード索引を置き、Common Table Expressionsで統合する。(出典1) |
| 結果の統合手段 | 標準提供のハイブリッド検索UDFが、Reciprocal Rank Fusionで一つの順位リストにまとめる。(出典1) | Common Table Expressionsで両方の順位を求め、RRFスコアを合成する構成例が示された。(出典1) |
EastBraverの見立て: 記事掲載例では、AlloyDBは標準UDFでReciprocal Rank Fusionによる統合を行い、Cloud SQLはCommon Table ExpressionsでRRFスコアを合成する。(出典1)
- 出典: Google Cloud(公式情報、2026-09-19 01:30 JST)
Google、AIエージェント型脆弱性スキャンを開発工程へ統合
Google AI and Infrastructureチームは、Googleのインフラへ展開するコードの各変更をチェックイン時にリアルタイム評価する提出前スキャンを、ソフトウェア開発ライフサイクルへ直接組み込んだとしている。(出典1)
スキャンは、ライブなコードベースのメタデータを使う局所的な脅威モデルを、パッケージやライブラリをまたぐ依存関係のコールグラフで拡張する。軽量スキャンの検出結果は、抽象構文木、コールグラフ、事前索引化した安全規則を使う専門トリアージエージェントが検証し、攻撃経路が実際に到達可能かを確認する。(出典1)
Googleによれば、専門トリアージエージェントの適合率は92%超で、処理時間は1分未満だった。また、局所的で精密な脅威モデルにより、偽陽性率は一部のケースで3%まで低下した。(出典1)
第2の防御層では、夜間の統合テスト中に提出後スキャンを行い、複数の変更をまたいで導入された可能性がある脆弱性を検査する。自動バグ修正エージェントは、スキャン結果と脆弱性の成立を示すコード断片から社内標準に沿う修正案を作り、元の変更リクエストのレビュー工程へ人間によるレビュー用として提出する。(出典1)
比較表: 提出前スキャンと提出後スキャンの役割
コード変更ごとの即時評価と、複数変更を横断する夜間検査を組み合わせた2層構成である。(出典1)
| 観点 | 提出前スキャン | 提出後スキャン |
|---|---|---|
| 実行時点 | コードのチェックイン時にリアルタイムで実行する。(出典1) | 夜間の統合テスト中、オフピーク時間に実行する。(出典1) |
| 検査範囲 | Googleのインフラへ展開するコードの各変更を評価する。(出典1) | 複数の変更をまたいで導入された可能性がある脆弱性を検査する。(出典1) |
EastBraverの見立て: 運用設計の要点は、チェックイン時の低遅延な検証と、夜間に複数変更を横断する検査を分け、修正案の最終判断を人間によるレビュー工程に残した点にある。(出典1)
- 出典: Google Cloud(公式情報、2026-09-19 01:00 JST)
関連する技術ガイド: AI Agent
AgentCore Runtime新版、起動とメモリ課金を刷新
AWSは、エージェントをインフラ管理なしで実行するマネージドコンピューティング層「AgentCore Runtime」の新版を発表した。ゼロまでのスケールと従量課金は従来版から継承し、主にメモリ回収と起動方式を変更した。(出典1)
新版は小さい常駐メモリからセッションを開始し、必要なメモリをオンデマンドで読み込む。解放済みまたは使われなくなったメモリはセッション終了前でも回収し、課金対象のメモリ使用量もセッション中の増減を反映する。(出典1)
新版は、ランタイムのインスタンスの作成・更新時にコンテナを起動し、初期化済み環境を一度スナップショット化して、新規インスタンスごとに復元する。不要なキャッシュなどを除いてスナップショットを小さく保ち、イメージ容量や同時実行数に左右されにくい一貫したコールドスタートを狙う方式だ。(出典1)
AWSが空のechoエージェントで各版・各イメージ容量を5,000回測定した結果、新版のP75コールドスタート遅延は200MBから2GBまで約2秒だった。従来版は約5.4秒から約30秒へ増加した。ただし、モデルとツールを使わず、us-west-2からus-east-1へ公開インターネット経由で呼び出したクライアント側の値であり、リージョン間の往復時間を含む。(出典1)
AWSによると、新版は高いメモリ単価を適用する一方、課金対象のGB時間が減り、多くのエージェントでは使用量の減少が単価上昇を上回るため請求額は下がる。この見通しは個別構成の削減率を示すものではない。また、既存コードや依存関係をそのまま移せるx86対応は提供済みではなく、近日提供予定である。(出典1)
比較表: 従来版と新版の実行特性
新版は従来のサーバーレス基盤を引き継ぎながら、ピーク時のメモリを保持する方式と初期化を繰り返す起動経路を改めた。(出典1)
| 観点 | 従来版 | 新版 |
|---|---|---|
| メモリ保持 | 割り当てたメモリを後続リクエストで使わなくても保持し、使用量は高水位に沿った。(出典1) | 小さい常駐領域から始め、必要時に読み込み、解放済みまたは使われないメモリを回収する。(出典1) |
| コールドスタート方式 | 新規インスタンスで初期化処理を実行する。(出典1) | 初期化済み環境の小さなスナップショットを復元する。(出典1) |
| AWS測定のP75遅延 | 200MBから2GBへの増加に伴い、約5.4秒から約30秒へ伸びた。(出典1) | 200MBから2GBまで、P75コールドスタート遅延は約2秒だった。(出典1) |
EastBraverの見立て: 起動改善は提示条件で明確だが、費用対効果は各エージェントのメモリ推移で変わる。測定値と料金見通しを分けて判断する必要がある。(出典1)
- 出典: AWS(公式情報、2026-09-19 00:31 JST)
関連する技術ガイド: AI AgentのMemory / AI Agent
SageMaker HyperPodにGPU対応ルーティングを追加
AWSは、既存のSageMaker HyperPod/EKSクラスタへEKSマネージドアドオンとして導入するSageMaker HyperPod Inference Gatewayを発表した。リアルタイムのGPU信号から推論要求の転送先Podを選び、モデルサーバーやクライアントアプリの変更は不要としている。(出典1)
クラスタ単位のゲートウェイが単一のプライベートエンドポイントを公開し、OpenAI互換リクエストのmodelフィールドからモデルプールを選ぶ。その後、KVキャッシュ使用率、キュー深度、LoRAアダプターの常駐を重み付きで評価し、バックエンドを決める。推論トラフィックにAWSリクエスト署名は求めない。(出典1)
モデルプールの処理能力が尽きた場合はHTTP 429とRetry-Afterヘッダーを返し、容量追加はオートスケーリングが担うとAWSは説明している。現時点の提供範囲は対応リージョン内のクラスタ単位ルーティングで、複数クラスタ・複数リージョンのフェイルオーバー、グローバルレート制限、コストを考慮した制御を担うGlobal Inference Routerは近日提供予定である。(出典1)
AWSの性能評価は既存のSageMaker推論エンドポイントとの比較ではなく、同じモデルレプリカを使うKubernetesのラウンドロビン基準である。AWSによれば、均一なGPU群と安定したトラフィックでは、ゲートウェイとの差は実行間変動の範囲に収まった。(出典1)
比較表: 現在の提供範囲と近日提供予定の範囲
現在は各クラスタ内のルーティングを担い、複数クラスタ・複数リージョンをまたぐ制御はGlobal Inference Routerで追加される予定である。(出典1)
| 観点 | 現在 | 近日提供予定 |
|---|---|---|
| 対象範囲 | 対応リージョンの各クラスタ内。(出典1) | 複数クラスタ・複数リージョン。(出典1) |
| トラフィック制御 | リアルタイムのGPU信号に基づいてクラスタ内のPodを選ぶ。(出典1) | クラスタ間フェイルオーバー、グローバルレート制限、コストを考慮した制御を行う。(出典1) |
EastBraverの見立て: 導入価値は一律な性能向上ではなく、リアルタイムのGPU状態を使うクラスタ内ルーティングが自社の負荷条件に合うかで判断すべきだ。均一なGPU群と安定負荷では、ラウンドロビンとの差が出ない可能性がある。(出典1)
- 出典: AWS(公式情報、2026-09-18 22:08 JST)
OpenAIへの侵入研究、Claude Opus 5で実用エクスプロイトを構築
Hacktron AIは、2件の脆弱性を連鎖させ、複数のOpenAI従業員のChatGPTアカウントと内部リポジトリへ到達したと報告した。内部コードを読まずに影響を示すため、従業員のCodexからOpenAI内部のモノレポへ無害なプルリクエストを作成し、その後は検証を停止したとしている。OpenAI自身による詳細なインシデント報告は確認できず、到達範囲は研究者側の報告に基づく。(出典1)
侵入経路は次の2段階だった。
- OpenAIのコミュニティーフォーラムで、細工したHEIF画像を処理するlibheifの脆弱性からDiscourseサーバー上のリモートコード実行へ到達した。(出典1 / 出典2)
- 研究者の説明では、OpenAIのSSO設定上の問題を組み合わせ、フォーラム利用者のChatGPTとCodexのアカウントへ到達した。(出典1)
Discourseの公式アドバイザリーは、libheifのCVE-2026-32882を悪用する画像アップロード経由のリモートコード実行をCVSS 8.8と評価した。修正版は2026.7.0、2026.6.1、2026.5.2、2026.1.6で、最新のDockerイメージにも修正版libheifを収録した。対応環境では画像処理の追加サンドボックスも導入している。(出典2)
Hacktron AIによると、Claude Opus 4.8はASLRを無効にした条件で動くエクスプロイトまで到達したが、Discourseの標準構成で安定して動かす作業には失敗した。Claude Opus 5の公開後は、3時間以内にARM64向けのローカルエクスプロイトを作成し、その後x86-64とjemallocを使うDiscourse環境へ移植した。翌朝までに画像アップロード経由のリモートコード実行を確認したとしている。(出典1)
EastBraverの見立て: 防御側はCVEの有無だけで優先順位を決めず、利用者が投入できる画像の処理を隔離し、SSOの信頼境界と接続先権限を別々に検証する必要がある。AIでエクスプロイト開発が短縮される前提に立ち、依存ライブラリの更新から侵害時の横展開防止までを一つの対策として扱うべきだ。(出典1 / 出典2)
- 出典: TechCrunch(二次情報、2026-09-18 23:00 JST) / Hacktron AI(調査報告、2026-09-13) / Discourse Security Advisory(公式情報、2026-07-28)
関連する技術ガイド: AI AgentのSandbox
